

이 글에서는 파이썬 asyncio를 간단히 소개하고, 멀티스레딩에 비해 asyncio가 갖는 장점을 이야기 해보겠습니다. 그리고 제가 속해 있는 Data Platform팀에서 asyncio를 활용해 광고 데이터 수집의 효율을 어떻게 높이고 있는지 소개하고자 합니다. 그러면 이야기를 시작해 볼까요.
asyncio는 비동기 I/O 프로그래밍을 위한 파이썬 기본 라이브러리로 파이썬 3.4에서 도입되었고, 3.5에서 async, await 키워드가 추가되면서 더 쉽게 사용할 수 있게 되었습니다.
그러면 비동기(asynchronous) I/O 프로그래밍이란 무엇이고, 왜 필요한 것일까요? 컴퓨터는 프로그램을 실행할 때 CPU, 메모리, 스토리지, 네트워크와 같은 자원들을 사용합니다. 그리고 I/O는 일반적으로 스토리지나 네트워크로부터 데이터를 읽거나 쓰는 작업을 말합니다. 그런데 I/O는 CPU, 메모리에 비해 처리 속도가 매우 느리기 때문에, I/O 바운드 프로세스인 경우에 비효율적인 상황이 생깁니다.
requests 라이브러리로 HTTP API를 호출하는 상황을 생각해 보겠습니다.
예제 1 HTTP API 호출 (동기)
# request_http_api_sync.py
from time import perf_counter
import requests
response_list = []
def get_campaigns():
    for i in range(1000):
        url = f"http://localhost:8000/campaigns/{i}"
        response = requests.get(url)
        response_list.append(response.text)
stime = perf_counter()
get_campaigns()
print(f"elapsed time: {perf_counter() - stime:.2f} seconds")
위의 코드는 특정 광고 캠페인의 정보를 가져오는 HTTP API를 1000번 호출하는 상황을 가정하였습니다. 여기서 requests.get으로 요청을 보낸 뒤, 프로그램은 응답을 받기까지 대기하게 됩니다.
이러한 방식을 동기(synchronous) I/O라고 합니다.
응답을 받기까지 대략 1초가 걸린다고 한다면, 위의 코드가 실행되는 데는 최소 1000초 이상이 필요합니다.
실제로 로컬에 mock server를 구성하고 테스트 해보면 다음과 같습니다.
% python request_http_api_sync.py
elapsed time: 1005.58 seconds
그리고 이 경우 CPU는 대부분의 시간을 대기 상태(wait state)로 있게 됩니다. CPU가 네트워크 I/O를 기다리느라 놀고 있는 것이죠. 매우 비효율적인 상황입니다.
만약 위의 상황이 비효율적이라고 느껴지지 않는다면, 음식 배달 주문을 하는 상황을 생각해 보겠습니다. 치킨, 피자, 족발을 각각 전화로 배달 주문하려고 합니다. 어떤식으로 주문을 하시나요? 아마 대부분은 치킨을 주문한 뒤 바로 이어서 피자, 족발을 주문하고 음식이 올 때까지 기다릴 것입니다. 혹시 치킨을 주문한 뒤에 바로 피자를 주문하지 않고, 치킨이 도착할 때까지 기다렸다가 피자를 주문하는 경우가 있을까요? 아마 없을 것입니다.
비동기 I/O도 비슷한 개념입니다. 간단히 말하면 I/O로 인해 대기가 발생했을 때, 완료되기를 기다리는 동안 다른 작업을 수행할 수 있도록 하는 것입니다. 위에서 예시로 든 HTTP API를 1000번 호출하는 상황에 비동기 I/O를 적용하면, API 요청을 보내고 응답을 받기까지 대기하는 동안 다른 API를 호출할 수 있습니다. HTTP API를 1000번 호출하는 상황에서 동기와 비동기의 차이를 간략히 도식화 하면 다음과 같습니다.
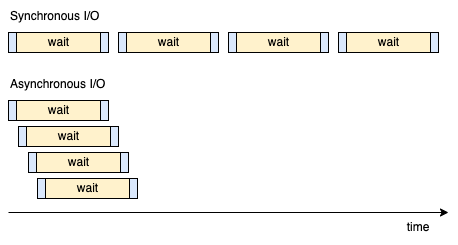
Synchronous I/O vs Asynchronous I/O
위 그림에서 파란색 부분은 HTTP 요청을 보내고 받는, 코드가 실행되는 부분으로 보시면 되고, 노란색 부분은 서버의 응답을 기다리는 상태입니다. 동기 I/O는 순차적으로 실행되는 반면, 비동기 I/O는 대기 상태에 진입하면 다음 API를 호출하게 됩니다. 따라서 그림에서도 직관적으로 볼 수 있는 것처럼, 비동기 I/O는 실행 시간을 크게 줄일 수 있습니다.
지금까지 비동기 I/O의 장점에 대해 간략하게 살펴보았습니다. 다음으로 asyncio의 기본적인 구성 요소에 대해 간략히 설명하겠습니다.
위에서 비동기 I/O에 대해 설명할 때, 대기가 발생하면 완료되기를 기다리는 동안 다른 작업을 수행할 수 있도록 한다고 했습니다. 그렇다면 여러 작업들의 실행을 스케줄링 하는 뭔가가 필요하겠죠? 그게 바로 이벤트 루프입니다.
비동기 함수는 말 그대로 비동기로 동작하는 함수이며, async def 키워드를 사용하여 정의합니다. 그리고 이러한 비동기 함수를 호출하면 코루틴이 됩니다.
(yield가 포함된 함수를 호출하면 제너레이터가 되는 것과 비슷합니다.)
>>> async def f():
...     pass
...
>>> type(f)
<class 'function'>
>>>
>>> coro = f()
>>> type(coro)
<class 'coroutine'>
그러면 코루틴은 무엇일까요? 코루틴은 완료되지 않은 채 일시 정지했던 함수를 다시 시작할 수 있는 기능을 가진 객체입니다.
제너레이터와 비슷하지 않나요? 실제로 파이썬 3.4에서는 제너레이터와 특별한 데커레이터를 통해 asyncio 라이브러리를 사용했었습니다.
그러다 파이썬 3.5에서 async def, await 키워드를 도입하면서 지금의 모습을 갖추게 되었습니다. 그래서 현재의 코루틴을 과거의 제너레이터 기반 코루틴과 구분하기 위해 네이티브 코루틴이라고 부르기도 합니다.
이러한 코루틴은 이벤트 루프에 등록되어 스케줄링에 따라 실행되게 됩니다.
await 키워드는 비동기 함수 안에서만 사용할 수 있는 키워드로 하나의 코루틴을 매개변수로 받으며, 비동기 함수 안에서 (다른 비동기 함수를 호출하여 생성한) 코루틴이 완전히 실행될 때까지 대기하도록 하는 역할을 합니다. 그리고 이벤트 루프에게 있어 await는 다른 코루틴으로 스케줄링 하는 시점이 됩니다.
Future는 미래에 완료될 어떤 동작의 상태를 나타내기 위한 클래스이며, Future 인스턴스를 통해 이벤프 루프에 등록된 작업의 결과를 받아오거나 작업을 취소할 수 있습니다. Task는 코루틴을 대상으로 하는 Future의 하위 클래스이며, Task 인스턴스를 통해 (Future와 마찬가지로) 이벤트 루프에 등록된 코루틴의 실행 결과를 받아오거나 코루틴을 동작을 취소할 수 있습니다.
지금까지 asyncio의 기본적인 구성 요소들을 살펴봤습니다. 그러면 asyncio를 적용한 코드를 살펴볼까요? 예제 1을 asyncio를 사용한 코드로 바꿔보면 다음과 같습니다.
예제 2 HTTP API 호출 (비동기)
# request_http_api_async.py
from time import perf_counter
import asyncio
import aiohttp
async def get_campaign(campaign_id: int):
    async with aiohttp.ClientSession() as session:
        url = f"http://localhost:8000/campaigns/{campaign_id}"
        async with session.get(url) as response:
            return await response.text()
async def get_campaigns():
    coro_list = [get_campaign(i) for i in range(1000)]
    response_list = await asyncio.gather(*coro_list)
stime = perf_counter()
asyncio.run(get_campaigns())
print(f"elapsed time: {perf_counter() - stime:.2f} seconds")
비동기 HTTP 통신을 위해 aiohttp 라이브러리를 사용했습니다. get_campaign은 aiohttp를 사용해 캠페인 정보를 가져오는 비동기 함수이며, get_campaigns에서 이 비동기 함수를 호출해서 만든 코루틴들의 리스트인 coro_list를 만들었습니다.
즉 campaign_id 0~999까지 각각의 캠페인 정보를 가져오는 코루틴 1000개가 만들어졌습니다. asyncio.gather는 여러 개의 코루틴 또는 태스크를 모아서 처리할 수 있도록 해줍니다.
그래서 await asyncio.gather(*coro_list) 코드는 1000개의 코루틴이 모두 완료될 때까지 대기하게 됩니다.
끝으로 asyncio.run은 이벤트 루프를 새로 만들고 파라미터로 받은 코루틴의 실행이 완료될 때까지 대기하게 되는데, 일반적으로는 asyncio.run(main())과 같이 비동기 프로그램의 main 함수를 실행시키는 역할을 합니다.
여기서 강조하고 싶은 것은 코드에 대한 자세한 설명보다 asyncio를 통해 얼마나 소요 시간을 줄일 수 있는지입니다. 다음은 위의 코드를 실행한 결과입니다.
% python request_http_api_async.py
elapsed time: 1.55 seconds
예제 1에서 1000초가 넘게 걸렸던 소요 시간이 1.55초로 줄었습니다. 이러한 간단한 예제를 통해 네트워크 통신이 많이 발생하는 프로그램에서 왜 asyncio를 사용해야 하는지 알 수 있습니다.
위에서 asyncio를 사용하여 동시에 여러 개의 HTTP 요청을 보내는 것을 살펴보았습니다. 동시에 여러 개의 작업을 실행해야 할 때 많이 사용하는 다른 방법에는 멀티스레딩이 있습니다. 새로운 스레드를 생성하여 병렬로 실행하는 것이죠. 여기서는 멀티스레딩을 사용하는 것과 비교했을 때 asyncio의 장점을 이야기 해보고자 합니다. 물론 모든 경우에 asyncio가 멀티스레딩보다 낫다라고 말하고 싶은 것은 아닙니다. 분명 멀티스레딩이 더 적합한 상황이 존재합니다. 여기서는 네트워크 통신과 같이 I/O가 많이 발생하는 상황을 기준으로 설명하겠습니다.
우선 스레딩과 asyncio 사이에 존재하는 근본적인 차이에 대해 이야기 해보고자 합니다. 스레드는 OS에서 제공하는 기능이며 한 프로세스 내에서 코드를 병렬로 실행하고자 할 때 사용합니다. 이때 각 스레드는 다른 CPU 코어에서 실행될 수 있습니다. 즉 물리적으로 병렬(parallel) 처리가 이뤄집니다. 그래서 계산량이 많은 작업을 병렬로 나눠서 처리할 때도 많이 사용합니다. 하지만 파이썬에서는 GIL(Global Interpreter Lock)이라는 존재 때문에 한 번에 하나의 바이트코드만 실행할 수 있기 때문에 이러한 병렬성에 제한이 있습니다.
asyncio는 OS가 아닌 프로그램 영역에서 제공하는 기능입니다. 하나의 스레드에서 이벤트 루프를 만들고 코루틴 또는 태스크라고 하는 것들을 번갈아가면서 실행하는 것입니다. 스레드처럼 물리적으로 병렬 처리하는 것은 아니기 때문에 asyncio를 사용한다고 해서 계산상의 이점은 없습니다. 대신 asyncio는 I/O가 발생할 때 block 하지 않고 다른 코루틴, 태스크를 실행할 수 있도록 스케줄링 해주기 때문에 여러 I/O 작업들이 동시에(concurrent) 실행되는 것처럼 느끼게 해주는 것입니다.
그러면 스레딩에 비해 asyncio가 가진 장점을 2가지만 이야기 해보겠습니다.
멀티스레딩으로 복잡한 프로그램을 개발해본 분이라면, 경합 조건으로 생긴 버그를 디버깅 하느라 고생했던 적이 있으실 것입니다. 멀티스레딩은 스레드들이 병렬로 실행되기 때문에 공유 자원을 동시에 접근하는 경우에 경합 조건이라는 문제가 생길 수 있습니다. 하지만 asyncio는 물리적 병렬(parallel) 실행이 아닌 논리적 동시(concurrent) 실행이기 때문에, 프로세스 내부에서 발생할 수 있는 대부분의 경합 조건을 쉽게 피할 수 있습니다. 또한 await 키워드를 통해 코루틴 간에 제어가 전환되는 시점을 개발자가 확인할 수 있기 때문에 경합 조건을 피하는데 도움이 됩니다. 이러한 이유로 MSA(Micro Service Architecture) 환경에서 프로세스 외부의 공유 자원에 대해 생길 수 있는 경합 조건도 쉽게 방지할 수 있습니다.
asyncio는 스레딩에 비해 더 적은 자원을 사용합니다. 스레드는 생성될 때 별도의 스택 메모리 공간을 할당하여 사용하지만, asyncio는 단일 스레드에서 실행되기 때문에 별도의 스택 메모리 공간이 필요하지 않습니다.
또한 CPU 사용에 있어서도 asyncio가 스레딩보다 효율적입니다.
병렬 처리를 위해 1000개의 스레드를 생성했다고 생각해 볼까요. 스레드 개수가 CPU 코어보다 많기 때문에 계속해서 context switching이 발생하게 됩니다.
이러한 context switching은 스레드가 I/O로 인해 block 된 상태에서도 계속해서 발생하며,
OS는 이러한 스레드들을 관리하고 스케줄링 하는데 시간과 자원을 사용하게 됩니다.
asyncio는 단일 스레드에서 실행되기 때문에 이러한 스레드 간의 context switching이 필요하지 않으며, select, poll, epoll과 같은 시스템 콜을 통해 실행 재개가 필요한지를 확인할 수 있어 효율적으로 코루틴 간의 실행을 전환할 수 있습니다.
그러면 예제 2를 멀티스레딩을 사용하도록 수정해볼까요? 수정된 코드와 실행 결과는 다음과 같습니다.
예제 3 HTTP API 호출 (멀티스레딩)
# request_http_api_threads.py
from concurrent.futures import ThreadPoolExecutor
from time import perf_counter
import requests
def get_campaign(campaign_id: int):
    url = f"http://localhost:8000/campaigns/{campaign_id}"
    response = requests.get(url)
    return response.text
def get_campaigns():
    with ThreadPoolExecutor(max_workers=1000) as exe:
        futures = [exe.submit(get_campaign, i) for i in range(1000)]
        response_list = [future.result() for future in futures]
stime = perf_counter()
get_campaigns()
print(f"elapsed time: {perf_counter() - stime:.2f} seconds")
% python request_http_api_threads.py
elapsed time: 1.77 seconds멀티스레딩이 조금(0.22 초) 더 시간이 걸렸습니다. 큰 차이는 아니지만 asyncio가 멀티스레딩보다 조금 빠름을 확인할 수 있었습니다. time 명령어를 적용해보면 더 많은 정보를 얻을 수 있습니다.
% time python request_http_api_async.py
elapsed time: 1.55 seconds
python request_http_api_async.py  0.56s user 0.17s system 42% cpu 1.743 total
% time python request_http_api_threads.py
elapsed time: 1.77 seconds
python request_http_api_threads.py  0.93s user 0.43s system 72% cpu 1.878 total
위의 결과를 보면, asyncio를 사용하는 코드가 CPU를 더 적게 사용했다는 것을 확인할 수 있습니다. 그러면 메모리 사용량은 어떨까요? memory_profiler를 사용하여 확인한 결과는 다음과 같습니다.
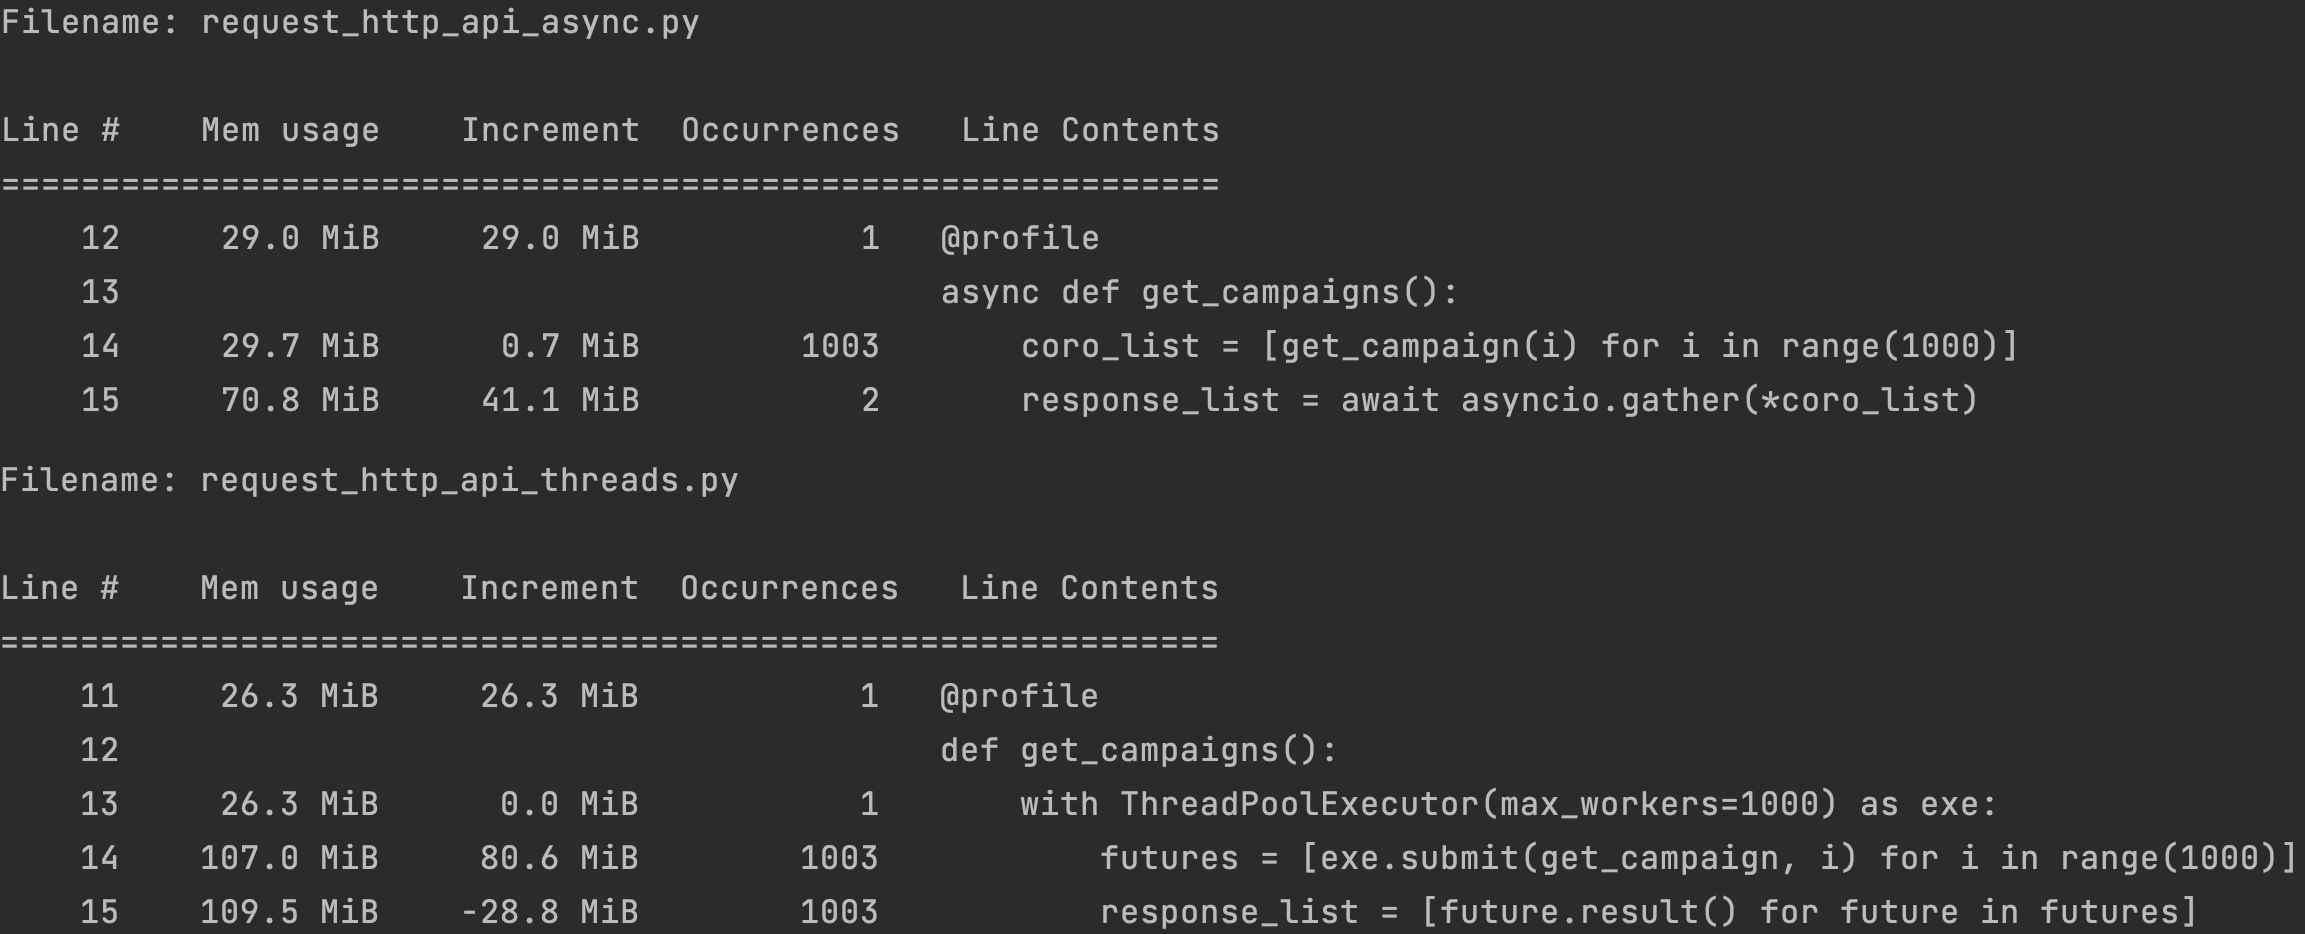
asyncio가 멀티스레딩에 비해 메모리 사용량도 적음을 확인할 수 있습니다. 이러한 차이가 크지 않게 느껴지실 수도 있습니다. 하지만 더 적은 시간과 자원을 사용하면서도 경합 조건과 같은 멀티스레딩을 사용할 때 겪을 수 있는 문제를 피할 수 있게 해 준다는 점에서 asyncio는 충분히 사용할 가치가 있다고 생각합니다.
제가 속해 있는 매드업의 Data Platform팀에서는 여러 광고 매체 또는 트래커에서 제공하는 API를 사용하여 광고 성과 지표들을 수집하고 있습니다. 주로 HTTP API를 호출하여 받아온 데이터를 필요에 맞게 가공한 뒤 데이터 웨어하우스에 저장하게 됩니다. 이러한 광고 데이터 수집을 위해 프리즘이란 시스템을 운영하고 있는데, 프리즘은 여러 마이크로 서비스로 구성되어 있습니다. 그중에서 수집을 담당하는 컬렉터와 스로틀링 처리를 하는 스로틀러에서 asyncio를 어떻게 사용하고 있는지 소개하겠습니다.
컬렉터는 데이터 수집을 담당하는 서비스입니다. 주된 작업은 HTTP API를 호출한 결과를 파일로 저장하고 AWS S3에 업로드 하는 것입니다. 이러한 작업을 효율적으로 하기 위해 asyncio를 사용하고 있는데, 각 과정을 asyncio 기반 비동기로 처리하기 위해 다음과 같은 라이브러리들을 사용하고 있습니다.
asyncio를 적용하여 수집 효율을 높이게 되었고, 컬렉터 서비스에 필요한 컨테이너 개수를 줄일 수 있었습니다.
스로틀러는 HTTP API의 호출 제한을 지키기 위해 사용하는 서비스입니다. 광고 매체나 트래커에서 제공하는 API에는 호출 횟수나 간격에 대한 제한이 있는 경우가 있습니다. 예를 들면 어떤 API는 동일한 광고 계정에 대해 5초당 1번만 호출할 수 있다거나, 1시간 동안 60회 이상을 호출하면 안 된다는 식의 제한이 있습니다. 그래서 이러한 제한들을 모두 지키면서 API를 호출하기 위해서는 API를 호출하는 흐름을 제어하는 역할이 필요하고, 그 역할을 스로틀러가 맡고 있습니다. (스로틀링에 대한 자세한 내용은 어서 와, 광고 데이터 수집은 처음이지? (FEAT. KRAKEN)를 참조 바랍니다.)
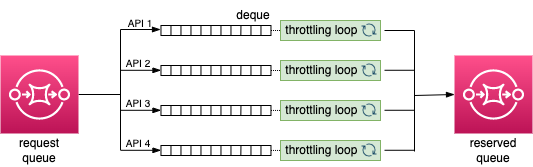
스로틀러가 하는 일을 대략적으로 도식화 하면 위의 그림과 같은데, 프로세스를 간단히 설명하면 다음과 같습니다.
위의 그림에서는 스로틀링 루프를 4개만 표시했지만, 실제로 필요한 스로틀링 루프는 수천 개가 될 수 있습니다 (매체 또는 트래커 개수 × API 개수 × 광고 계정 개수). 그리고 스로틀링 루프들은 동시에 실행되어야 합니다.
동시 실행을 위해 스레딩을 사용한다면 어떨까요? 스레딩을 사용할 수는 있습니다. 하지만 스레딩은 asyncio에 비해 자원을 많이 사용하게 되고 context switching이 계속 발생하는 것도 비효율적이라고 판단했습니다. 그래서 asyncio를 사용하기로 하였고, 스로틀링 루프에 해당하는 부분을 코루틴으로 만들어 이벤트 루프에서 돌아가도록 했습니다. asyncio를 적용하여 더 적은 자원으로 스로틀링을 효율적으로 하게 된 것이죠.
지금까지 비동기 I/O란 무엇인지, 그리고 파이썬에서 비동기 I/O를 사용하기 위한 표준 라이브러리인 asyncio에 대해 간략하게 살펴봤습니다. 그리고 매드업의 Data Platform팀에서 asyncio를 사용해 어떻게 광고 데이터 수집의 효율을 높이고 있는지 소개했습니다.
아마 많은 파이썬 개발자 분들이 이미 asyncio를 사용하고 계실거라 생각합니다. 아직 사용하지 않고 있고 I/O의 비중이 큰 프로그램을 개발하고 계시다면 asyncio를 꼭 사용해 보시면 좋겠습니다.
이 글에서는 지면 관계상 asyncio 라이브러리에 속한 함수들에 대한 자세한 설명보다는 왜 asyncio를 사용해야 하는지에 초점을 맞춰서 설명하고자 했습니다. 다음에 기회가 되면 함수들에 대한 자세한 설명과 함께 asyncio 기반 프로그램을 우아하게 종료하는 방법에 대해서도 다른 글을 통해 소개해 드리도록 하겠습니다.

<매드업>은 개인정보보호법에 따라 이용자의 개인정보 보호 및 권익을 보호하고 개인정보와 관련한 이용자의 고충을 원활하게 처리할 수 있도록 다음과 같은 처리방침을 두고 있습니다.
<매드업>은 회사는 개인정보처리방침을 개정하는 경우 웹사이트 공지사항(또는 개별공지)을 통하여 공지할 것입니다.
○ 본 방침은 2020년 1월 15일부터 시행됩니다.
개인정보의 처리 목적 <매드업>은 개인정보를 다음의 목적을 위해 처리합니다. 처리한 개인정보는 다음의 목적 이외의 용도로는 사용되지 않으며 이용 목적이 변경될 시에는 사전동의를 구할 예정입니다.
가. 홈페이지 회원가입 및 관리 회원 가입의사 확인, 회원제 서비스 제공에 따른 본인 식별·인증, 회원자격 유지·관리, 제한적 본인확인제 시행에 따른 본인확인, 서비스 부정이용 방지, 만14세 미만 아동 개인정보 수집 시 법정대리인 동의 여부 확인, 각종 고지·통지, 고충처리, 분쟁 조정을 위한 기록 보존 등을 목적으로 개인정보를 처리합니다.
나. 민원사무 처리 민원인의 신원 확인, 민원사항 확인, 사실조사를 위한 연락·통지, 처리결과 통보 등을 목적으로 개인정보를 처리합니다.
다. 재화 또는 서비스 제공 물품배송, 서비스 제공, 청구서 발송, 콘텐츠 제공, 맞춤 서비스 제공, 본인인증, 연령인증, 요금결제·정산 등을 목적으로 개인정보를 처리합니다.
라. 마케팅 및 광고에의 활용 신규 서비스(제품) 개발 및 맞춤 서비스 제공, 이벤트 및 광고성 정보 제공 및 참여기회 제공 , 인구통계학적 특성에 따른 서비스 제공 및 광고 게재 , 서비스의 유효성 확인, 접속빈도 파악 또는 회원의 서비스 이용에 대한 통계 등을 목적으로 개인정보를 처리합니다.
개인정보 파일 현황
가. 개인정보 파일명 : 개인정보 처리방침
개인정보 항목 : 이메일, 휴대전화번호, 비밀번호, 이름, 업체명, 제목, 광고 예산, 내용, 사업자 등록 번호, 신용카드정보, 은행계좌정보, 예금주, 생년월일, 서비스 이용 기록, 접속 로그, 쿠키, 접속 IP 정보, 결제기록
수집방법 : 홈페이지, 계약서
보유근거 : 홈페이지 회원정보 수집 등에 관한 기록
보유기간 : 5년
관련법령 : 대금결제 및 재화 등의 공급에 관한 기록 : 5년
개인정보의 처리 및 보유 기간 ① <매드업>은 법령에 따른 개인정보 보유·이용기간 또는 정보주체로부터 개인정보를 수집 시에 동의 받은 개인정보 보유,이용기간 내에서 개인정보를 처리,보유합니다. ② 각각의 개인정보 처리 및 보유 기간은 다음과 같습니다.
가. <홈페이지 회원가입 및 관리> <홈페이지 회원가입 및 관리>와 관련한 개인정보는 수집.이용에 관한 동의일로부터<5년>까지 위 이용목적을 위하여 보유.이용됩니다.
보유근거 : 홈페이지 회원정보 수집 등에 관한 기록
관련법령 : 대금결제 및 재화 등의 공급에 관한 기록 : 5년
예외사유 :
나. <재화 또는 서비스 제공> <재화 또는 서비스 제공>와 관련한 개인정보는 수집.이용에 관한 동의일로부터<5년>까지 위 이용목적을 위하여 보유.이용됩니다.
보유근거 : 계약 또는 청약철회 등에 관한 기록
관련법령 : 계약 또는 청약철회 등에 관한 기록 : 5년
예외사유 :
다. <마케팅 및 광고에의 활용> <마케팅 및 광고에의 활용>와 관련한 개인정보는 수집.이용에 관한 동의일로부터<3년>까지 위 이용목적을 위하여 보유.이용됩니다.
보유근거 : 전자상거래등에서의 소비자보호에 관한 법률
관련법령 : 소비자의 불만 또는 분쟁처리에 관한 기록 : 3년
예외사유 :
정보 주체와 법정대리인의 권리·의무 및 그 행사방법 이용자는 개인정보주체로써 다음과 같은 권리를 행사할 수 있습니다.
① 정보주체는 매드업에 대해 언제든지 개인정보 열람,정정,삭제,처리 정지 요구 등의 권리를 행사할 수 있습니다.
② 제1항에 따른 권리 행사는 매드업에 대해 개인정보 보호법 시행령 제41조제1항에 따라 서면, 전자우편, 모사전송(FAX) 등을 통하여 하실 수 있으며 매드업은 이에 대해 지체 없이 조치하겠습니다.
③ 제1항에 따른 권리 행사는 정보주체의 법정대리인이나 위임을 받은 자 등 대리인을 통하여 하실 수 있습니다. 이 경우 개인정보 보호법 시행규칙 별지 제11호 서식에 따른 위임장을 제출하셔야 합니다.
④ 개인정보 열람 및 처리 정지 요구는 개인정보보호법 제35조 제5항, 제37조 제2항에 의하여 정보주체의 권리가 제한 될 수 있습니다.
⑤ 개인정보의 정정 및 삭제 요구는 다른 법령에서 그 개인정보가 수집 대상으로 명시되어 있는 경우에는 그 삭제를 요구할 수 없습니다.
⑥ 매드업은 정보주체 권리에 따른 열람의 요구, 정정·삭제의 요구, 처리 정지의 요구 시 열람 등 요구를 한 자가 본인이거나 정당한 대리인인지를 확인합니다.
처리하는 개인정보의 항목 작성
① <매드업>은 다음의 개인정보 항목을 처리하고 있습니다.
가. <홈페이지 문의 및 관리>
필수항목 : 업체명, 이메일, 제목, 연락처, 광고 예산, 내용, 휴대전화번호, 비밀번호, 이름, 서비스 이용 기록, 접속 로그, 쿠키, 접속 IP 정보
선택항목 : 프로필 사진
나. <재화 또는 서비스 제공>
필수항목 : 업체명, 이메일, 제목, 연락처, 광고 예산, 내용, 비밀번호, 이름, 회사명, 사업자 등록 번호, 신용카드정보, 은행계좌정보, 예금주, 생년월일, 서비스 이용 기록, 접속 로그, 쿠키, 접속 IP 정보, 결제기록
선택항목 :
다. <마케팅 및 광고에의 활용>
필수항목 : 업체명, 이메일, 제목, 연락처, 광고 예산, 내용, 휴대전화번호, 이름, 서비스 이용 기록, 접속 로그, 쿠키, 접속 IP 정보
선택항목 :
개인정보의 파기<매드업>은 원칙적으로 개인정보 처리 목적이 달성된 경우에는 지체없이 해당 개인정보를 파기합니다. 파기의 절차, 기한 및 방법은 다음과 같습니다.
파기절차
이용자가 입력한 정보는 목적 달성 후 별도의 DB에 옮겨져(종이의 경우 별도의 서류) 내부 방침 및 기타 관련 법령에 따라 일정기간 저장된 후 혹은 즉시 파기됩니다. 이 때, DB로 옮겨진 개인정보는 법률에 의한 경우가 아니고서는 다른 목적으로 이용되지 않습니다.
파기기한
이용자의 개인정보는 개인정보의 보유기간이 경과된 경우에는 보유기간의 종료일로부터 5일 이내에, 개인정보의 처리 목적 달성, 해당 서비스의 폐지, 사업의 종료 등 그 개인정보가 불필요하게 되었을 때에는 개인정보의 처리가 불필요한 것으로 인정되는 날로부터 5일 이내에 그 개인정보를 파기합니다.
파기방법
전자적 파일 형태의 정보는 기록을 재생할 수 없는 기술적 방법을 사용합니다. 종이에 출력된 개인정보는 분쇄기로 분쇄하거나 소각을 통하여 파기합니다.
개인정보 자동 수집 장치의 설치•운영 및 거부에 관한 사항
① 매드업은 개별적인 맞춤서비스를 제공하기 위해 이용 정보를 저장하고 수시로 불러오는 ‘쿠키(cookie)’를 사용합니다.
② 쿠키는 웹사이트를 운영하는데 이용되는 서버(http)가 이용자의 컴퓨터 브라우저에게 보내는 소량의 정보이며 이용자들의 PC 컴퓨터 내의 하드디스크에 저장되기도 합니다.
가. 쿠키의 사용 목적 : 이용자가 방문한 각 서비스와 웹 사이트들에 대한 방문 및 이용형태, 인기 검색어, 보안접속 여부, 등을 파악하여 이용자에게 최적화된 정보 제공을 위해 사용됩니다.
나. 쿠키의 설치•운영 및 거부 : 웹브라우저 상단의 도구>인터넷 옵션>개인정보 메뉴의 옵션 설정을 통해 쿠키 저장을 거부 할 수 있습니다.
다. 쿠키 저장을 거부할 경우 맞춤형 서비스 이용에 어려움이 발생할 수 있습니다.
개인정보 보호책임자 작성
① 매드업은 개인정보 처리에 관한 업무를 총괄해서 책임지고, 개인정보 처리와 관련한 정보주체의 불만처리 및 피해구제 등을 위하여 아래와 같이 개인정보 보호책임자를 지정하고 있습니다.
▶ 개인정보 보호책임자
성명 : 강남석
직책 : CFO
직급 : CFO
연락처 : 02-1522-1060, contact@madup.com
※ 개인정보 보호 담당부서로 연결됩니다.
▶ 개인정보 보호 담당부서
부서명 : General Affairs Team
담당자 : 민상준
연락처 : 02-1522-1060, contact@madup.com
② 정보 주체께서는 매드업의 서비스(또는 사업)을 이용하시면서 발생한 모든 개인정보 보호 관련 문의, 불만처리, 피해구제 등에 관한 사항을 개인정보 보호책임자 및 담당부서로 문의하실 수 있습니다. 매드업은 정보주체의 문의에 대해 지체 없이 답변 및 처리해드릴 것입니다.
개인정보 처리방침 변경
① 이 개인정보처리방침은 시행일로부터 적용되며, 법령 및 방침에 따른 변경 내용의 추가, 삭제 및 정정이 있는 경우에는 변경사항의 시행 7일 전부터 공지사항을 통하여 고지할 것입니다.
개인정보의 안전성 확보 조치 <매드업>은 개인정보보호법 제29조에 따라 다음과 같이 안전성 확보에 필요한 기술적/관리적 및 물리적 조치를 하고 있습니다.
가. 정기적인 자체 감사 실시 개인정보 취급 관련 안정성 확보를 위해 정기적(분기 1회)으로 자체 감사를 실시하고 있습니다.
나. 개인정보 취급 직원의 최소화 및 교육 개인정보를 취급하는 직원을 지정하고 담당자에 한정시켜 최소화 하여 개인정보를 관리하는 대책을 시행하고 있습니다.
다. 내부관리계획의 수립 및 시행 개인정보의 안전한 처리를 위하여 내부관리계획을 수립하고 시행하고 있습니다.
라. 해킹 등에 대비한 기술적 대책 <매드업>은 해킹이나 컴퓨터 바이러스 등에 의한 개인정보 유출 및 훼손을 막기 위하여 보안프로그램을 설치하고 주기적인 갱신·점검을 하며 외부로부터 접근이 통제된 구역에 시스템을 설치하고 기술적/물리적으로 감시 및 차단하고 있습니다.
마. 개인정보의 암호화 이용자의 개인정보는 비밀번호는 암호화 되어 저장 및 관리되고 있어, 본인만이 알 수 있으며 중요한 데이터는 파일 및 전송 데이터를 암호화 하거나 파일 잠금 기능을 사용하는 등의 별도 보안기능을 사용하고 있습니다.
바. 접속 기록의 보관 및 위변조 방지 개인정보처리시스템에 접속한 기록을 최소 6개월 이상 보관, 관리하고 있으며, 접속 기록이 위변조 및 도난, 분실되지 않도록 보안기능 사용하고 있습니다.
사. 개인정보에 대한 접근 제한 개인정보를 처리하는 데이터베이스시스템에 대한 접근 권한의 부여,변경,말소를 통하여 개인정보에 대한 접근통제를 위하여 필요한 조치를 하고 있으며 침입차단시스템을 이용하여 외부로부터의 무단 접근을 통제하고 있습니다.
아. 문서 보안을 위한 잠금 장치 사용 개인정보가 포함된 서류, 보조저장매체 등을 잠금 장치가 있는 안전한 장소에 보관하고 있습니다.
자. 비인가자에 대한 출입 통제 개인정보를 보관하고 있는 물리적 보관 장소를 별도로 두고 이에 대해 출입통제 절차를 수립, 운영하고 있습니다.